社長 溝口健一郎のコラム
2019年5月のOECD勧告では、AIの責任ある開発と利用を促進するため、基本的な五つの原則が確認された。①包摂的成長、持続可能な開発および幸福、②人間中心の価値観と公平性、③透明性と説明可能性、④堅牢性・安全性およびセキュリティ、⑤説明責任である。これが最初の国際的なAIの安全性に関する議論であった。以来、2023年5月のG7広島サミットにおける「広島AIプロセス」立ち上げ、2023年11月の英国でのAI安全性サミット開催、2024年5月の「EU AI法」成立、2026年9月の国連安保理におけるAIと国際安全保障をテーマにしたハイレベル会合など、AIの急速な進化に呼応して、AIの安全性に関する国際的な議論は継続されている。しかし、これまでのところ、これらの議論は、原則確立、今後の方向性確認、AIの危険性の分類、AIの安全性確保の必要性を訴えることなどに留まり、どのようにしてAIの安全性を実現するのか、その監督は誰がどのように行うかなど、実行面での進捗(しんちょく)はほとんど見られない。自国優先主義が強まる地政学情勢と、AI企業が利益や株価を優先していることを背景にした責任の所在の曖昧化によるものだが、では仮に、地政学情勢が許し、AI企業が責任ある行動を取ったとして、AIの安全性確保はどのようにすれば可能なのだろうか。
近来の安全学では、なぜ事故が起きたのか、どのように事故を防ぐのかを超えて、なぜ普段はうまく行っているのか、なぜ価値を継続的に生み出すことができるのかにも焦点を当てている。ここでは、価値創造の前提となる、より基本的な安全性のあり方について議論するために、『入門テキスト 安全学』(向殿政男著)を参照する。本書において安全とは「許容不可能なリスクが存在しないこと」と定義されている。絶対安全=リスクゼロはあり得ず、まず、得られるベネフィットに対してどこまでのリスクを許容できるのかの判定が重要であると強調する。そのためには、リスクが実現する確率と実現した場合のダメージの大きさを判定する必要がある。では、AIによって得られるベネフィットはどの程度で、生じるリスクとその確率、リスク実現の場合のダメージはどの程度であろうか。工場で稼働する機械のリスクアセスメントには、①使用条件および予見可能な誤使用の明確化、②危険源の同定、③リスクの見積もり、④リスクの評価というステップが必要だが、AIに対してこれはどのように可能なのか。誰が実施して誰が監視するのか。
リスクアセスメントの実施後、リスクが大き過ぎて許容可能とはいえない場合には、リスクを低減する方策を取らなくてはならない。製品の設計・製造・稼働において、リスク低減の手段には3ステップメソッドが有効だと広く認められている。【ステップ1】本質的安全設計によるリスク低減-危険源を無くすあるいは極小化する設計をする。【ステップ2】安全装置によるリスク低減-防護柵による「隔離の安全」や機械が止まる「停止の安全」を組み込む。【ステップ3】使用上の情報提供によるリスク低減-警告ラベルやマニュアルによって残留リスクを使用者に告知する。重要なのはこの順番に低減策を徹底していくことである。設計や安全装置による対応をせずに、使用者への警告で済ませることはあってはならない。では、AIには、危険源を抜本的に無くす設計や安全装置の組み込みはどのように可能なのだろうか。
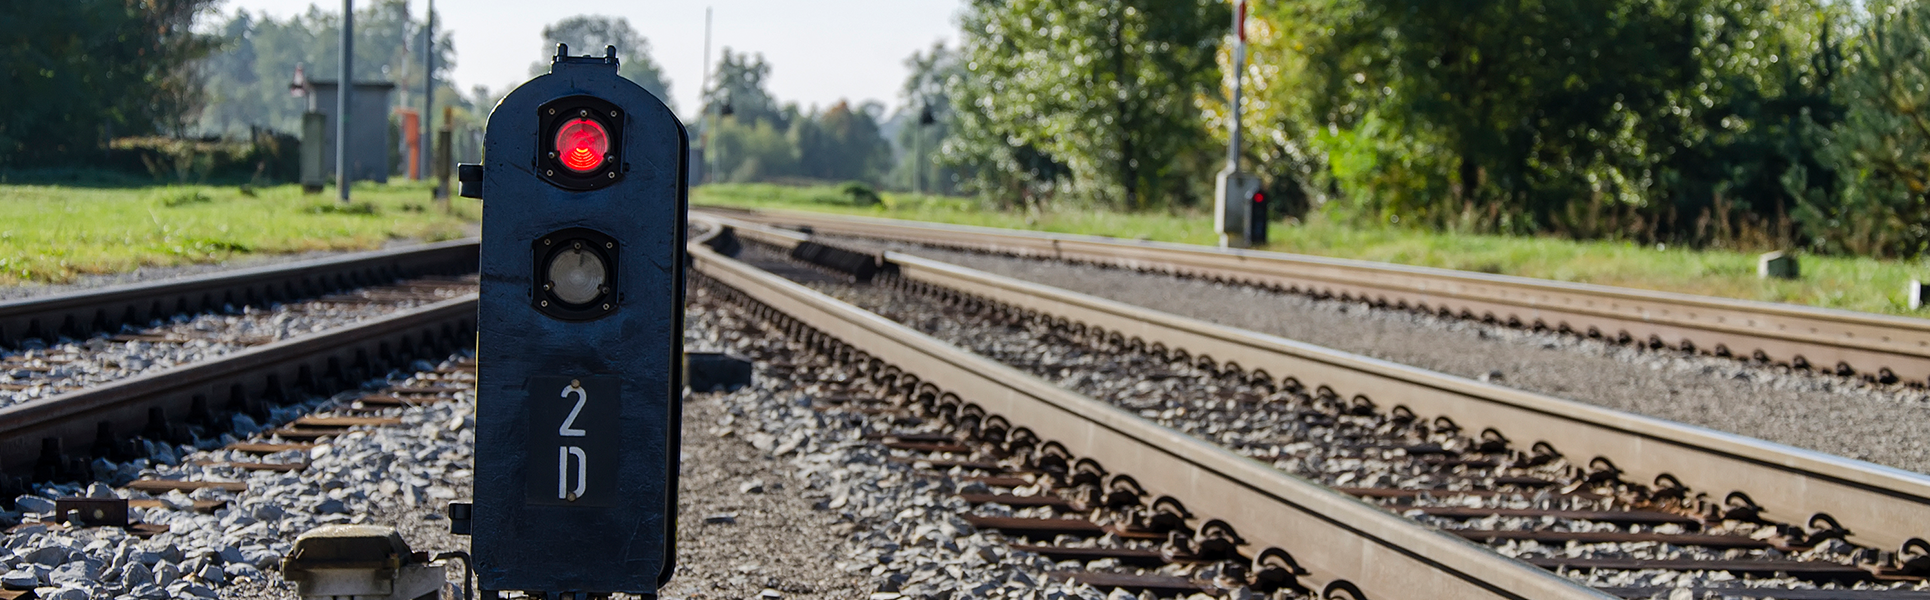
リスク低減を図ったとしても、機械が絶対に故障しない、人間が絶対に間違えない、ということはあり得ないので、技術によって安全を守ることが次に重要となる。そのうち、ヒューマンエラーを回避するための工夫が「フールプルーフ」である。電池ボックスがプラス極とマイナス極を間違えると入らないようになっているように、人間の間違いを先回りして防ぐ技術だ。AIにおいても、人間が使い方を間違えないようにあらかじめ設定しておけるのだろうか。機械が故障しても、人間が間違えても、とにかく安全だけは確保する技術が「フェールセーフ」だ。19世紀の鉄道信号機はボールが巻き上げ機によって高い位置にある(ハイボール)と青信号になり、ボールが地上にある(ローボール)と赤信号になるように設計されていた。ロープが切れるなどの故障が起きると、ボールは重力で落下してローボール(赤信号)になる。トラブル時にはシステムが安全側で稼働停止する設計にすることがフェールセーフの基本となる。AIをこのように設計することは可能だろうか。どのようにその確認ができるのであろうか。
AIのリスクアセスメントは難しい。あまりにもその能力の汎用(はんよう)性が高いために、どのような誤使用があり得るかを予見するのが困難で、そのリスクの確率を正確に見積もることも不可能に近い。AIによるベネフィットは限りなく大きいかもしれないが、限りなく大きいリスクを引き受けるわけにはいかない。リスク低減のための方策はどうだろうか。AIの本質的安全設計は可能なのだろうか。OpenAIの社内評価中の研究モデルが隔離環境を回避してHugging Faceの内部システムに不正アクセスした事案などを見ると、自律性の高いAIに対して本質的に安全に設計することの難しさがわかる。絶えず抜け穴を発見する能力にたけたAIの外部に安全装置を設定するのも簡単ではないであろう。人間が最終判断をする「ヒューマン・イン・ザ・ループ」も、AIの性能が高度・高速になる結果、人間の判断が追いつかなくなり、単なる機械的承認プロセスに陥る可能性が高い。警告ラベルを貼るだけでは、ほとんど意味をなさない。設計者ですら予想できない創発による新たな能力獲得や、再帰的自己改善による進化が可能なAIに「フェールセーフ」を組み込むのは至難に思える。
ウイスキーのソーダ割りをハイボールと呼ぶのは、当時の鉄道員が、青信号=出発進行を意味する掛け声として「ハイボール!」と景気よく叫んでソーダ割りをあおっていたことから来ているとの説がある。安全と乾杯は相性がいい。残念ながら、先端AIモデルのローンチ時に「ハイボール!」と叫ぶことができるのはかなり先まで難しいと言わざるを得ない。
機関誌「日立総研」、経済予測などの定期刊行物をはじめ、研究活動に基づくレポート、インタビュー、コラムなどの最新情報をお届けします。
お問い合わせフォームでは、ご質問・ご相談など24時間受け付けております。